Мониторинг веб-системы: что нужно контролировать
Мониторинг часто воспринимают как проверку доступности: сервер отвечает, сайт открывается — значит, всё работает. Для небольшого проекта этого иногда достаточно. Для интернет-магазина, B2B-платформы, личного кабинета или другого критичного веб-сервиса — уже нет.
Система может отдавать страницы и при этом не принимать заказы. Каталог может работать со старыми остатками. Интеграция с ERP — не передавать данные несколько часов. Очередь фоновых задач — постепенно расти, пока задержка не станет критической. Пользователь видит работающий сайт, но отдельные бизнес-процессы уже нарушены.
Поэтому хороший мониторинг должен отвечать не только на вопрос «система доступна?», но и на более важный: «выполняет ли она сейчас те функции, ради которых существует?»
Уровень 1. Доступность системы
Самая базовая проверка — доступен ли веб-сервис извне. Она позволяет обнаружить полный отказ сайта, API или отдельного критичного компонента.
Обычно контролируют:
- доступность основных URL и API;
- HTTP-статусы;
- время ответа;
- доступность DNS;
- срок действия SSL-сертификата;
- доступность внешних точек входа.
Но простой запрос к главной странице даёт очень ограниченную информацию. Сервер может вернуть 200 OK, хотя авторизация уже не работает, каталог не загружается, а оформление заказа завершается ошибкой.
Поэтому availability-мониторинг нужен, но это только первый слой.
Уровень 2. Инфраструктура
Следующий уровень показывает, хватает ли системе ресурсов и нормально ли работают её основные технические компоненты. Здесь могут контролироваться загрузка процессоров, оперативная память, дисковое пространство, скорость дисковых операций, сеть, контейнеры, виртуальные машины и другие элементы инфраструктуры.
Важны не только аварийные значения, но и динамика. Если свободное место на диске постепенно уменьшается, полезнее получить предупреждение заранее, чем узнать о проблеме после заполнения диска.
То же относится к памяти или процессору. Кратковременный пик сам по себе может быть нормальным, а стабильная загрузка около предельных значений — признаком того, что система приближается к ограничению.
Уровень 3. Приложение
Сервер может быть полностью исправен, а само приложение — работать с ошибками. Поэтому отдельно нужны показатели уровня программного обеспечения:
- количество ошибок приложения;
- доля запросов с ошибками;
- время выполнения запросов;
- медленные операции;
- исключения;
- состояние фоновых процессов;
- количество перезапусков отдельных компонентов.
Полезно видеть не только абсолютное число ошибок. Если на миллион запросов приходится десять ошибок, ситуация одна. Если те же десять ошибок возникли на двадцати запросах конкретного критичного API — совсем другая.
Поэтому технические показатели желательно оценивать в контексте объёма операций и конкретных функций системы.
Уровень 4. База данных
Для многих веб-проектов база данных становится одним из основных потенциальных узких мест. Проблемы здесь не всегда приводят к мгновенному падению сервиса: сначала могут постепенно увеличиваться задержки. В зависимости от архитектуры имеет смысл отслеживать:
- доступность базы;
- время выполнения запросов;
- медленные запросы;
- количество соединений;
- блокировки;
- нагрузку;
- состояние репликации;
- объём данных и свободное пространство;
- ошибки.
При этом задача мониторинга — не собрать максимально возможное количество технических показателей. Нужно определить, какие изменения действительно способны повлиять на работу конкретного проекта.
Уровень 5. Очереди и фоновые задачи
Современная веб-система далеко не всё делает непосредственно во время пользовательского запроса. Импорт товаров, обработка изображений, отправка уведомлений, генерация документов, синхронизация с внешними системами и другие операции могут выполняться асинхронно. Из-за этого возникает опасный сценарий: интерфейс работает нормально, но внутри системы постепенно накапливаются необработанные задачи.
Для очередей полезно контролировать их размер, возраст самой старой задачи, скорость обработки, количество ошибок и повторных попыток. Особенно показателен именно возраст задачи. Очередь из тысячи элементов может быть нормальной, если она обрабатывается за несколько секунд. Десять задач, которые лежат несколько часов, уже могут свидетельствовать о проблеме.
Уровень 6. Интеграции
Для e-commerce и B2B-проектов работоспособность собственного сайта — только часть картины. Система может зависеть от 1С, ERP, CRM, платёжных сервисов, служб доставки, поиска, внешних API и десятков других источников. Здесь важно знать:
- доступен ли внешний сервис;
- проходят ли запросы;
- каково время ответа;
- сколько возникает ошибок;
- когда состоялся последний успешный обмен;
- сколько операций ожидают повторной обработки;
- насколько актуальны полученные данные.
Последний пункт особенно важен. Интеграция может технически не выдавать ошибок, но данные перестали обновляться. Например, обмен остатков формально запущен, однако последние актуальные сведения были получены шесть часов назад. Поэтому мониторить стоит не только факт выполнения процесса, но и свежесть результата.
Уровень 7. Критичные пользовательские сценарии
Это один из самых полезных уровней для бизнеса. Вместо проверки отдельных компонентов система периодически выполняет действие, похожее на действия настоящего пользователя. Например:
открыть каталог → найти товар → добавить его в корзину → перейти к оформлению заказа.
Для B2B-платформы сценарий может выглядеть иначе:
авторизоваться → получить персональные цены → сформировать заказ → убедиться, что он появился в системе.
Такие проверки часто называют синтетическим мониторингом. Их ценность в том, что они тестируют сразу всю цепочку. База данных, сервер и API могут по отдельности выглядеть исправными. Но если клиент не способен оформить заказ, для бизнеса система в этот момент всё равно не работает.
Уровень 8. Бизнес-метрики
Есть проблемы, которые технический мониторинг вообще может не заметить.
Представим интернет-магазин, который обычно получает десятки заказов в час. В течение двух часов не поступило ни одного. При этом сайт доступен, ошибок приложения нет, процессоры практически свободны. Это может быть обычным снижением спроса. А может означать, что сломалась кнопка оформления заказа.
Поэтому для критичных проектов полезно контролировать аномалии в бизнес-показателях:
- количество заказов;
- число оплат;
- успешность платежей;
- регистрации;
- отправленные заявки;
- объём обмена данными;
- количество созданных документов;
- другие ключевые операции.
Такие метрики связывают техническое состояние системы с тем, что действительно важно компании.
Не каждый скачок требует будить разработчика
Собрать метрики сравнительно просто. Сложнее настроить полезные уведомления. Если система отправляет десятки сообщений из-за каждого кратковременного скачка нагрузки, команда довольно быстро перестаёт на них реагировать. Возникает alert fatigue: действительно важное сообщение теряется среди постоянного шума. Поэтому для каждого показателя нужно определить условия, при которых ситуация действительно требует внимания.
Например, имеет значение не единичный медленный запрос, а рост времени ответа в течение нескольких минут. Не одна ошибка интеграции, а серия ошибок или отсутствие успешного обмена дольше допустимого периода.
Хороший мониторинг должен сокращать время реакции, а не создавать дополнительный информационный поток.
Уведомления должны учитывать критичность
Не каждая проблема требует одинаковой реакции. Условно события можно разделить на несколько уровней:
- Информационное предупреждение можно проверить в рабочее время.
- Значимая деградация требует реакции команды в ближайшее время.
- Полная недоступность оформления заказов или потеря критичной интеграции может требовать немедленного уведомления ответственного специалиста.
Такой подход особенно важен при поддержке по SLA. Сам факт наличия мониторинга ещё не определяет качество поддержки — должны быть понятны правила эскалации и реакции на разные типы событий.
Логи нужны для ответа на вопрос «почему»
Метрика показывает, что что-то изменилось. Лог помогает разобраться, что именно произошло. Если выросло количество ошибок, команда должна иметь возможность перейти от сигнала к конкретным запросам, операциям и сообщениям приложения. Иначе мониторинг обнаружит проблему, но расследование всё равно займёт часы.
При этом просто хранить все возможные логи недостаточно. В распределённой системе одна пользовательская операция может пройти через несколько сервисов. Полезно иметь идентификатор, по которому можно проследить её путь и собрать связанные события.
Для сложных архитектур к метрикам и логам добавляется трассировка запросов — она помогает увидеть, на каком участке цепочки возникает задержка или ошибка.
Нужно контролировать резервное копирование
Сообщение «резервное копирование настроено» не означает, что резервные копии действительно создаются каждый день. Поэтому мониторинг должен проверять хотя бы факт успешного выполнения backup-процедур, актуальность последней копии и наличие ошибок.
Но даже этого недостаточно для полной уверенности. Отдельно необходимо периодически проверять восстановление данных. Мониторинг способен сообщить, что файл резервной копии создан, но только тестовое восстановление подтверждает, что им действительно можно воспользоваться.
Безопасность тоже оставляет наблюдаемые сигналы
Мониторинг эксплуатации и информационная безопасность — не одно и то же, но часть событий полезно отслеживать совместно. Например, резкий рост неуспешных попыток авторизации, необычное количество запросов, внезапное изменение характера трафика или серия запрещённых операций могут быть признаками проблемы.
Набор таких сигналов зависит от архитектуры и требований безопасности. Не стоит пытаться заменить системой технического мониторинга специализированные средства защиты, но полностью игнорировать подобные аномалии тоже не нужно.
Мониторинг должен показывать состояние системы целиком
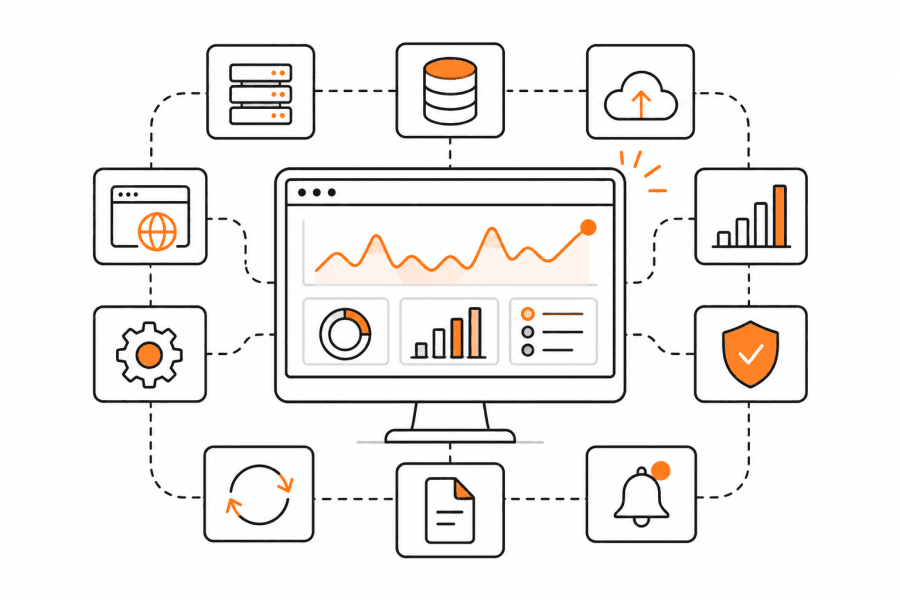
Удобно, когда ключевые показатели собраны на дашбордах по уровням: инфраструктура, приложение, базы данных, интеграции, пользовательские сценарии и бизнес-операции. Это особенно полезно во время инцидента. Если одновременно выросло время ответа сайта, увеличилось число медленных запросов к базе и начала расти очередь, взаимосвязь видна быстрее, чем при просмотре отдельных систем мониторинга.
При этом дашборд не должен превращаться в стену из сотни графиков. Его задача — дать быстрый ответ на вопрос, в каком состоянии находится сервис сейчас и где искать причину отклонения.
Что в итоге стоит контролировать
Для критичной веб-системы базовую модель мониторинга можно представить так:
| Уровень | Что проверяем |
|---|---|
| Доступность | Сайт, API, DNS, SSL, время ответа |
| Инфраструктура | CPU, память, диски, сеть, состояние узлов |
| Приложение | Ошибки, время выполнения, исключения, фоновые процессы |
| Данные | Базы, запросы, соединения, блокировки, репликация |
| Асинхронные процессы | Очереди, возраст задач, ошибки обработки |
| Интеграции | Доступность, ошибки, последний успешный обмен, свежесть данных |
| Пользовательские сценарии | Авторизация, поиск, корзина, заказ и другие критичные цепочки |
| Бизнес | Заказы, оплаты, заявки и другие ключевые операции |
| Восстановление | Успешность и актуальность резервного копирования |
| Аномалии | Необычное поведение и отдельные сигналы безопасности |
Конкретный набор всегда зависит от системы. Мониторить все существующие показатели «на всякий случай» не нужно. Сначала стоит определить критичные бизнес-процессы, затем понять, какие компоненты обеспечивают их работу, и уже после этого выбрать метрики и пороги.
Тогда мониторинг перестаёт быть набором графиков для разработчиков. Он становится механизмом, который позволяет заметить проблему до того, как она успеет превратиться в потерянные заказы, недоступный сервис или несколько часов ручного восстановления.
Похожая задача у вас?
Статья описывает общий случай. Опишите свой — разберём на ваших вводных: что применимо, что нет и с чего дешевле начать.
Ещё по теме
Другие материалы из архива — о разработке, процессах и технологиях.

SLA или блок часов: какая модель поддержки нужна проекту

Работа над сайтом — как ремонт: закончить невозможно, можно только приостановить

Вся правда о технической поддержке сайта