Архитектура высоконагруженной системы: какие доказательства нужны бизнесу
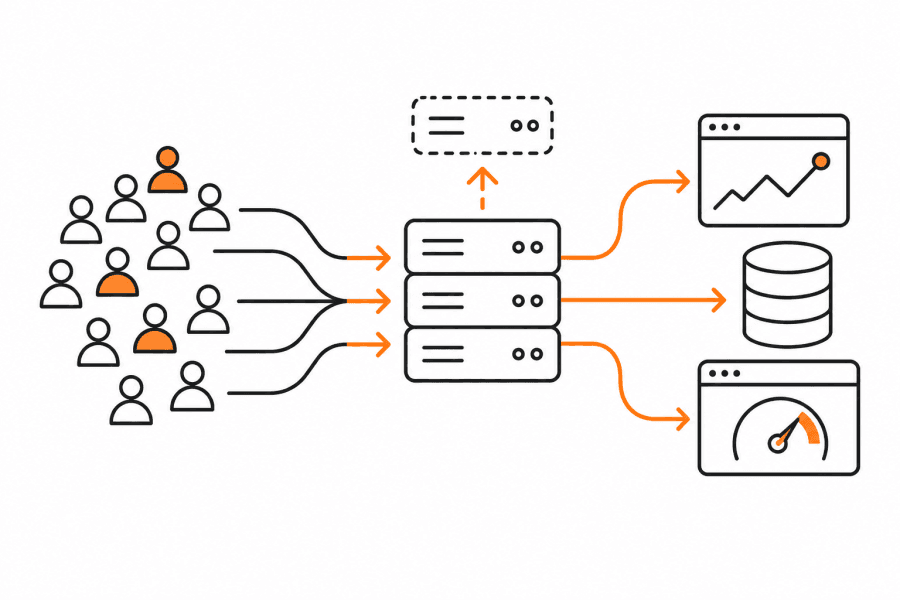
«Система выдерживает высокую нагрузку» звучит убедительно, пока не возникает вопрос: какую именно нагрузку и откуда это известно?
Для бизнеса высоконагруженность сама по себе не является характеристикой качества. Важнее другое: сможет ли интернет-магазин пережить распродажу, обработает ли B2B-платформа одновременно тысячи операций, не остановится ли сервис при резком росте трафика и сколько времени потребуется на восстановление после сбоя.
Поэтому при выборе архитектуры и подрядчика стоит смотреть не столько на слова о highload, сколько на доказательства. Причём доказать нужно не сложность технического решения, а его способность работать в конкретных условиях бизнеса.
Начать не с серверов, а с нагрузки
Нельзя спроектировать высоконагруженную систему, если неизвестно, что именно означает «высокая нагрузка» для конкретного проекта. Для одного интернет-магазина критичны десятки тысяч посетителей во время акции. Для другого основную нагрузку создаёт каталог с миллионами товаров и постоянным обновлением цен и остатков. В B2B-системе пользователей может быть относительно немного, зато один запрос запускает сложные расчёты, обращения к ERP и обработку большого объёма данных.
Поэтому сначала нужны исходные показатели:
- количество пользователей и одновременных сессий;
- число запросов и операций в единицу времени;
- объём каталога и других данных;
- частота обновления цен, остатков и других сущностей;
- количество заказов или транзакций;
- объём интеграционного обмена;
- обычная и пиковая нагрузка;
- ожидаемый рост.
Без этих цифр нельзя проверить, соответствует ли архитектура реальной задаче. Можно только сказать, что она выглядит технически убедительно.
Средняя нагрузка мало говорит о пиках
Предположим, интернет-магазин получает 100 000 посещений в сутки. Делить эту цифру на 24 часа и проектировать инфраструктуру под полученное среднее значение опасно. Пользователи распределяются неравномерно. Реклама, рассылка, начало распродажи или сезонный спрос могут привести значительную часть аудитории за короткий промежуток времени.
То же происходит с внутренними процессами. Например, ERP может отправлять крупные обновления каталога по расписанию именно тогда, когда на сайте растёт пользовательская активность. Поэтому архитектуру стоит проверять не только на среднем сценарии, но и на расчётном пике. Для бизнеса это означает ответ на конкретный вопрос: что произойдёт с системой в самый сложный для неё период?
Нагрузочное тестирование должно напоминать реальную работу
Количество одновременных пользователей само по себе ещё не доказывает производительность. Можно отправить на сервер тысячи простых запросов к одной странице и получить отличный результат. Но реальный пользователь открывает каталог, применяет фильтры, выполняет поиск, заходит в карточку товара, авторизуется, добавляет товар в корзину и оформляет заказ.
Эти операции создают разную нагрузку на приложение, базу данных, поиск, кеш, внешние сервисы и интеграции. Поэтому хороший нагрузочный тест моделирует сценарии, а не просто большое количество запросов. Для интернет-магазина можно отдельно проверить просмотр каталога, поиск, корзину, оформление заказа и работу личного кабинета, а затем запустить их в пропорциях, близких к реальному поведению пользователей. Результаты такого теста уже можно сравнивать с требованиями бизнеса.
Нужны цифры, а не вывод «тест пройден»
Отчёт о нагрузочном тестировании должен позволять понять, что происходило с системой. Минимально полезно видеть:
- какую нагрузку создавали;
- сколько операций система обработала;
- как менялось время ответа;
- сколько возникло ошибок;
- при какой нагрузке началась деградация;
- какие компоненты стали ограничением;
- насколько были загружены основные ресурсы.
Например, утверждение «сайт выдержал 3 000 одновременных пользователей» само по себе почти ничего не говорит. Гораздо полезнее знать, какие действия выполняли эти пользователи, сколько запросов проходило в секунду, каким было время ответа и появились ли ошибки.
Для бизнеса важен не рекорд, а рабочий диапазон системы.
Производительность должна быть связана с пользовательским сценарием
Техническая система может продолжать отвечать на запросы, но фактически уже быть непригодной для использования. Если каталог открывался за одну секунду, а под нагрузкой — за восемь, сервер формально продолжает работать. Для покупателя это уже заметная деградация. Поэтому до тестирования желательно определить допустимые показатели для критичных операций. Например, отдельно для каталога, поиска, добавления товара в корзину, оформления заказа или получения данных в личном кабинете.
Не обязательно устанавливать один норматив для всего проекта. Сложный отчёт в B2B-кабинете может формироваться дольше, чем карточка товара. Важно заранее понимать, какая скорость считается приемлемой именно для конкретной операции.
Архитектура должна показывать, где находится запас
Ещё один важный вопрос — что произойдёт, если нагрузка станет больше расчётной. Если система сегодня работает почти на пределе ресурсов, успешный тест текущей нагрузки мало что гарантирует. Новая рекламная кампания, рост каталога или увеличение числа клиентов снова приведут к проблеме. Поэтому бизнесу полезно знать не только текущую производительность, но и запас.
Например, тестовая нагрузка может превышать ожидаемый пик. Тогда становится понятно, в какой момент начинается деградация и насколько проект готов к росту. Но запас не обязательно означает покупку максимально мощных серверов заранее. Хорошая архитектура предусматривает возможность масштабировать именно те компоненты, которым это потребуется.
Масштабирование тоже нужно доказать
Фраза «при необходимости добавим сервер» не является планом масштабирования. Сначала нужно понимать, какой компонент становится узким местом. Приложение можно масштабировать горизонтально, но база данных, файловое хранилище или внешний сервис при этом могут остаться ограничением. Поэтому полезно проверить сценарий роста практически: увеличить нагрузку, добавить ресурсы или экземпляры нужного компонента и посмотреть, насколько изменилась производительность.
Если удвоение ресурсов почти не влияет на результат, значит ограничение находится в другом месте и простое наращивание инфраструктуры проблему не решит.
Отказоустойчивость — отдельная характеристика
Система может прекрасно справляться с десятками тысяч запросов, пока работает каждый её компонент. Но если отказ одного сервера останавливает весь сервис, архитектуру трудно назвать устойчивой. Поэтому кроме нагрузки нужны сценарии отказа.
Что произойдёт, если перестанет отвечать один сервер приложения? Если временно станет недоступна внешняя интеграция? Если возникнет проблема с базой данных? Если во время обработки накопится очередь задач?
Для критичных систем важно заранее понимать, какие компоненты резервируются, как происходит переключение, что случается с незавершёнными операциями и сколько времени занимает восстановление. И здесь бизнесу снова нужны не названия технологий, а проверяемый результат.
Важно знать допустимое время простоя и потери данных
Для разных систем последствия сбоя отличаются. Если внутренний отчёт недоступен десять минут, компания может этого почти не заметить. Десять минут недоступности оформления заказа во время крупной распродажи уже могут стоить ощутимых денег. Поэтому архитектурные решения имеет смысл связывать с двумя вопросами: сколько времени система может быть недоступна и какой объём данных допустимо потерять при аварии.
От этих требований зависят резервирование, резервные копии, репликация, частота сохранения данных и сценарии восстановления. Чем жёстче требования, тем сложнее и дороже инфраструктура. Поэтому выбирать максимальную отказоустойчивость «на всякий случай» так же нерационально, как и вообще её не проектировать.
Резервная копия — ещё не доказательство восстановления
Факт наличия бэкапов часто воспринимается как гарантия безопасности. Но резервная копия полезна только тогда, когда из неё действительно можно восстановить систему за приемлемое время. Поэтому проверять стоит не только создание копий, но и процедуру восстановления.
Где находятся резервные данные? Как часто они создаются? Проверяется ли их целостность? Сколько занимает восстановление? Кто и что должен сделать при аварии?
Тестовое восстановление даёт бизнесу гораздо больше информации, чем отметка «backup настроен».
Нужна наблюдаемость системы
После запуска архитектура продолжает меняться. Растёт каталог, добавляются интеграции, обновляется код, меняется поведение пользователей. Поэтому результаты нагрузочного тестирования перед релизом не остаются актуальными навсегда.
В промышленной эксплуатации нужны данные о состоянии системы: время ответа, количество ошибок, нагрузка на компоненты, состояние очередей, работа фоновых процессов и другие показатели, значимые для конкретного проекта.
Важно не просто собирать технические метрики, а настроить пороговые значения и уведомления. Команда должна узнать о деградации раньше, чем проблема превратится в массовые жалобы пользователей.
Проверять нужно и деградацию, а не только полный отказ
Система редко переходит из состояния «всё хорошо» сразу в состояние «ничего не работает». Чаще сначала растёт время ответа, накапливаются очереди, отдельные запросы завершаются ошибками, перестают вовремя обновляться данные.
Пользователи уже испытывают проблемы, хотя формально сервис доступен. Поэтому хорошая система мониторинга позволяет увидеть тенденцию: производительность ухудшается и приближается к опасной границе. Для бизнеса это особенно важно, потому что даёт время вмешаться до полноценной аварии.
Какие доказательства запросить у подрядчика
Не каждому заказчику нужен доступ к графикам загрузки процессора или подробная схема кластеризации. Но результаты технических решений должны переводиться на понятный бизнесу язык. Для высоконагруженного проекта разумно получить набор подтверждений:
| Что нужно подтвердить | Что может служить доказательством |
|---|---|
| Система выдерживает расчётную нагрузку | Результаты нагрузочного тестирования |
| Скорость остаётся приемлемой | Время ответа критичных операций под нагрузкой |
| Есть запас для роста | Тестирование выше ожидаемого пика |
| Система масштабируется | Результаты проверки при добавлении ресурсов |
| Отказ компонента не останавливает всё | Проверенные сценарии отказа |
| После аварии можно восстановиться | Тест восстановления из резервной копии |
| Проблемы можно обнаружить заранее | Мониторинг, метрики и автоматические уведомления |
| Архитектура соответствует реальному процессу | Нагрузочная модель на основе бизнес-сценариев |
Конкретный набор зависит от масштаба и критичности проекта. Небольшому корпоративному сервису не нужна инфраструктура крупного маркетплейса. Но если высокая нагрузка заявлена как существенное требование, её устойчивость должна подтверждаться измерениями.
Архитектура — это не список технологий
Redis, Kubernetes, очереди сообщений, репликация базы данных и балансировщики сами по себе ничего не доказывают. Каждая технология решает определённую задачу и одновременно усложняет систему. Поэтому вопрос бизнеса должен звучать не «используется ли здесь Kubernetes?», а «какую проблему решает этот компонент и чем подтверждено, что он здесь нужен?»
Иногда более простая архитектура с понятным запасом производительности, мониторингом и отработанным восстановлением оказывается надёжнее сложной системы, которую трудно сопровождать. Высоконагруженная архитектура становится ценностью для бизнеса не тогда, когда выглядит сложной на схеме, а когда её свойства можно проверить: известно, какую нагрузку она выдерживает, где начинаются ограничения, как она масштабируется, что происходит при сбоях и сколько времени требуется на восстановление.
Именно такие доказательства превращают обещание «мы сделали highload» в измеримый результат.
Похожая задача у вас?
Статья описывает общий случай. Опишите свой — разберём на ваших вводных: что применимо, что нет и с чего дешевле начать.
Ещё по теме
Другие материалы из архива — о разработке, процессах и технологиях.
Почему сайты иногда приходится переделывать уже через несколько лет
Этапы разработки MVP: от гипотезы до работающей версии
Когда компании нужна заказная разработка, а когда готовый продукт
Как сделать интеграцию интернет-магазина с 1С/ERP устойчивой
Как спроектировать личный кабинет для клиентов и партнёров