Как устроить очередь задач и регулярные релизы на поддержке
Поддержка сайта или веб-системы редко состоит только из срочных исправлений. Одновременно появляются небольшие доработки, технический долг, запросы бизнеса, обновления платформы, интеграции, аналитика и задачи, которые «хорошо бы сделать, когда будет время».
Если работать только по принципу «берём то, что сейчас громче всего», поддержка быстро превращается в хаотичный поток. Срочные задачи вытесняют плановые, небольшие доработки зависают на месяцы, а релизы становятся непредсказуемыми.
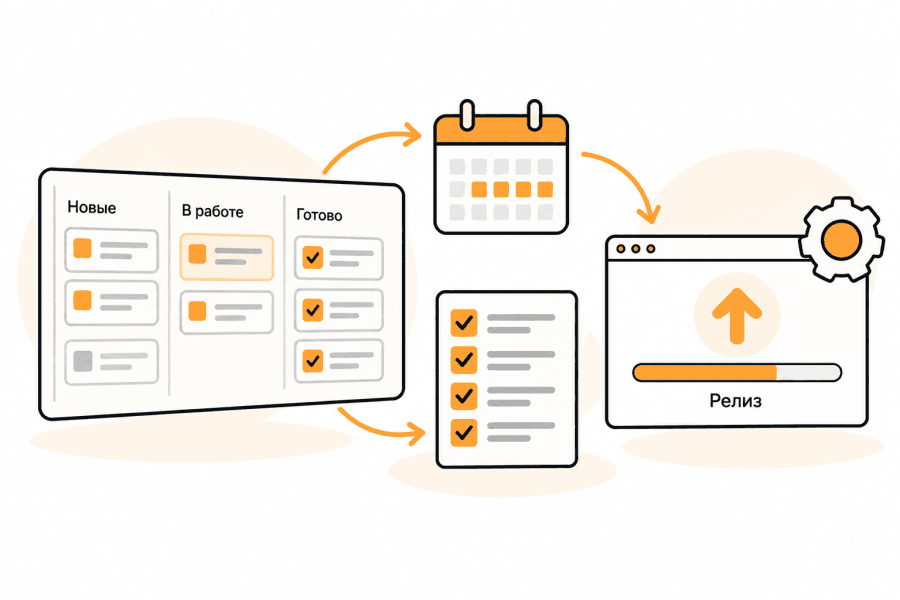
Поэтому у постоянной поддержки должна быть не только команда, но и понятный процесс: как задачи попадают в работу, кто определяет их приоритет, как формируется очередь и с какой регулярностью изменения выпускаются на production.
Все задачи должны попадать в одну очередь
Проблемы начинаются, когда часть задач приходит в мессенджер, часть — на почту, часть озвучивается на встрече, а ещё что-то разработчик «просто запомнил». В такой системе невозможно увидеть реальный объём работы и понять, что уже согласовано, что ждёт оценки и что было отложено.
Поэтому для поддержки полезно иметь единую очередь. Неважно, какой именно инструмент используется — трекер, Service Desk, корпоративный портал. Важно, чтобы каждая задача получила хотя бы минимальное описание и статус. Даже небольшой запрос вроде «добавить новое поле в форму» должен существовать как отдельная задача, если он требует разработки.
Очередь — это не просто список по дате создания
Если выполнять задачи строго в порядке поступления, критичная ошибка может ждать своей очереди за десятком косметических доработок. Поэтому задачи обычно различаются по типу и приоритету.
Можно условно выделить:
- аварии и критические ошибки;
- значимые дефекты;
- небольшие исправления;
- функциональные доработки;
- технические задачи;
- исследования и предварительные оценки.
Приоритет при этом должен зависеть не от того, кто первым написал, а от влияния на бизнес.
Если пользователь не может оформить заказ, задача очевидно важнее изменения подписи в административной панели. Если ошибка затрагивает одного сотрудника в редком сценарии, она может подождать ближайшего планового релиза. Главное — чтобы критерии были понятны обеим сторонам.
Срочная задача должна действительно быть срочной
Если половина очереди помечена как «срочно», приоритета фактически нет. Для экстренной обработки полезно оставить ограниченный круг ситуаций: недоступность системы, остановка критичного бизнес-процесса, массовая ошибка, потеря или искажение данных, существенная проблема безопасности.
Остальные задачи лучше проводить через обычную очередь. Это не означает, что их можно откладывать бесконечно. Наоборот, регулярный цикл поддержки позволяет быстро выпускать небольшие изменения и без режима постоянного аврала.
До постановки в разработку задачу нужно уточнить
Формулировка «добавить новый статус заказа» может выглядеть как работа на час. Но затем выясняется, что статус должен приходить из ERP, участвовать в уведомлениях, отображаться в личном кабинете и влиять на возможность отмены заказа.
Поэтому до попадания задачи непосредственно в разработку желательно понять:
- что нужно изменить;
- зачем это нужно;
- какие сценарии затрагиваются;
- какие системы участвуют;
- есть ли зависимости;
- какие критерии будут означать, что задача выполнена.
Для мелкой задачи это может занимать несколько минут. Для более сложной потребуется отдельный анализ. Так уменьшается количество ситуаций, когда объём работ резко меняется уже после старта.
Очередь должна учитывать зависимости
Некоторые задачи нельзя выполнять независимо. Например, новый функционал личного кабинета требует сначала изменить API. Обновление платформы желательно провести до разработки нового модуля. Новая интеграция зависит от документации внешней команды.
Если рассматривать такие задачи изолированно, очередь будет постоянно перестраиваться. Поэтому полезно заранее видеть зависимости и объединять связанные работы в последовательность. Иногда это приводит к тому, что небольшая на вид задача временно опускается ниже в очереди не потому, что она неважная, а потому что её пока нельзя нормально выполнить.
Нужно ограничивать количество задач «в работе»
Парадоксально, но попытка начать всё одновременно обычно замедляет поддержку.
Если у разработчика десять незавершённых задач, он постоянно переключается между контекстами. Часть ждёт ответа заказчика, часть — тестирования, часть — доработки со стороны интеграции.
Гораздо эффективнее ограничивать активную работу и доводить задачи до следующего состояния, прежде чем брать новые. Это особенно важно для небольшой команды поддержки, где одни и те же специалисты отвечают и за разработку, и за срочные инциденты. Очередь должна показывать не только «что когда-нибудь нужно сделать», но и что действительно находится в работе сейчас.
Регулярный релиз снижает количество случайных выкладок
Когда каждое небольшое изменение выпускается сразу после завершения, production постоянно меняется. Это удобно для одной задачи, но плохо для управляемости процесса: трудно понять, что именно вошло в конкретный релиз, какое изменение могло вызвать проблему и когда его проверяли.
Поэтому плановые задачи полезно объединять в регулярные релизы. Например, команда выпускает изменения раз в неделю или раз в две недели. Конкретный ритм зависит от проекта, объёма задач и критичности системы.
Главное — не сама частота, а предсказуемость. Бизнес понимает, когда ожидать доработку, а команда получает понятный цикл разработки, тестирования и выпуска.
Не все задачи должны ждать планового релиза
Регулярный график не означает, что критичную ошибку нужно оставить до пятницы. Для аварийных ситуаций должен существовать отдельный путь — hotfix. Такие изменения выпускаются вне обычного графика, но и процесс для них должен быть управляемым: минимально необходимая правка, проверка, фиксация изменения и последующий контроль.
Если же внеплановые релизы происходят постоянно, это сигнал, что либо сама система нестабильна, либо критерий «срочно» используется слишком широко.
Перед релизом нужен понятный состав изменений
Релиз не должен превращаться в случайный набор задач, которые «успели к четвергу». Перед выпуском полезно зафиксировать, что именно входит в текущую версию.
Это позволяет:
- проверить связанные изменения вместе;
- не включать незавершённые задачи;
- подготовить тестирование;
- заранее определить потенциально рискованные места;
- сообщить бизнесу, что изменится.
Для небольшого проекта release notes могут состоять буквально из нескольких пунктов. Для сложной системы список будет подробнее. Важно, чтобы после релиза можно было восстановить его состав.
Чем ближе релиз, тем меньше должна меняться его комплектация
Если прямо перед production продолжать добавлять новые задачи, тестирование постепенно теряет смысл. Проверили одну конфигурацию, затем добавили ещё две доработки, потом срочно исправили третью — в итоге в production уходит уже другой набор изменений.
Поэтому полезно иметь условную точку заморозки релиза: после неё внутрь попадают только действительно необходимые исправления. Остальное переносится на следующий цикл. Регулярный ритм делает такой перенос менее болезненным: задача не «уезжает в неизвестность», а просто попадает в следующий релиз.
Тестировать нужно не только конкретную задачу
Разработчик добавил новый фильтр каталога, проверил его — всё работает. Но изменение могло затронуть общий механизм выборки товаров и случайно повлиять на другую категорию. Поэтому кроме проверки самой задачи полезна хотя бы минимальная регрессия критичных сценариев.
Для интернет-магазина это обычно каталог, карточка товара, корзина, оформление заказа, авторизация и ключевые интеграции. Для B2B-платформы набор может включать ещё персональные цены, документы и роли.
Чем лучше автоматизированы такие проверки, тем быстрее можно выпускать регулярные релизы.
У релиза должен быть сценарий отката
Даже хорошо протестированное изменение иногда ведёт себя иначе на production. Поэтому заранее стоит понимать, что делать, если после выкладки появилась серьёзная проблема.
Иногда достаточно откатить конкретный коммит. Иногда потребуется вернуть предыдущую версию приложения. Если релиз меняет структуру данных, возврат может быть сложнее. Поэтому рискованные изменения лучше выявлять до выпуска и отдельно продумывать механизм rollback.
Регулярность релизов не должна означать, что каждый выпуск становится экспериментом на реальных пользователях.
После релиза нужно немного понаблюдать
Успешный deploy ещё не означает успешный релиз. Часть ошибок проявляется только при реальном трафике, фоновых задачах или интеграционных обменах.
Поэтому после выпуска стоит проверить:
- ошибки приложения;
- критичные бизнес-сценарии;
- интеграции;
- очереди;
- фоновые процессы;
- производительность;
- ключевые бизнес-показатели, если они доступны.
Для небольшого изменения это может быть короткая проверка. Для крупного релиза период наблюдения будет длиннее.
Незавершённые задачи не должны теряться между релизами
Если задача не попала в текущий выпуск, важно понять, что происходит дальше.
Она может:
- перейти в следующий релиз;
- вернуться на уточнение;
- потерять актуальность;
- ждать внешней зависимости;
- быть отложена по приоритету.
Для этого и нужна прозрачная очередь. Проблема не в том, что задача переносится. Проблема — когда через два месяца никто не помнит, почему её так и не сделали.
Технические задачи должны конкурировать за место честно
В поддержке легко бесконечно откладывать технический долг, потому что у бизнеса всегда есть более заметные функциональные запросы. Но если не обновлять зависимости, не улучшать тесты, не исправлять нестабильные интеграции и не разбирать проблемные участки кода, скорость разработки постепенно снижается.
Поэтому часть технических задач должна регулярно попадать в очередь релизов. Не обязательно устанавливать жёсткую квоту. Но команда должна иметь возможность объяснить, почему определённая техническая работа важна.
Например, обновление библиотеки само по себе может быть незаметно пользователям, но необходимо перед следующим обновлением PHP. Настройка автоматических тестов не добавляет новой функции, но сокращает риск будущих релизов. Тогда технический backlog перестаёт быть отдельным списком «когда-нибудь потом».
Полезно регулярно пересматривать очередь
Приоритет задачи не обязательно остаётся неизменным. То, что было важно два месяца назад, может потерять актуальность. И наоборот, небольшая задача может стать критичной после запуска новой услуги или маркетинговой кампании. Поэтому очередь полезно периодически пересматривать вместе с ответственным со стороны бизнеса.
Не требуется проводить отдельную большую встречу по каждой мелочи. Важно регулярно отвечать на три вопроса: Что делаем следующим? Что пока откладываем? Что уже больше не нужно?
Так backlog остаётся рабочим инструментом, а не историческим архивом пожеланий.
Ритм поддержки должен быть понятен заранее
У поддержки может быть разный цикл.
Например:
- в начале недели — уточняются приоритеты и состав ближайшего релиза;
- дальше — разработка и проверка;
- к концу недели — тестирование и выпуск;
- после релиза — наблюдение и подготовка следующих задач.
Для другой команды удобнее двухнедельный цикл. Где-то релизы происходят несколько раз в неделю.
Универсального правильного расписания нет. Хороший ритм — тот, который позволяет достаточно быстро отдавать изменения и при этом оставляет время на проверку.
Бизнесу важна не только скорость закрытия задач
Если измерять поддержку только количеством выполненных задач, команда может начать оптимизироваться на мелкие и простые изменения. Гораздо полезнее смотреть на процесс целиком.
Например:
- насколько предсказуемо задачи доходят до релиза;
- сколько возникает срочных hotfix;
- сколько задач долго находится в работе;
- как часто релизы приходится откатывать;
- уменьшается или растёт технический долг;
- насколько быстро команда реагирует на критичные проблемы.
Такие показатели помогают увидеть, является ли поддержка управляемой. Не обязательно превращать их в сложную систему KPI. Иногда достаточно просто регулярно смотреть на тенденцию.
Хорошая очередь не означает жёсткий план на месяцы вперёд
Поддержка по определению работает в меняющейся среде. Появляются новые бизнес-задачи, ошибки, внешние изменения и срочные запросы. Поэтому нет смысла расписывать очередь до конкретных дат на полгода вперёд.
Гораздо полезнее иметь:
- понятный верх очереди;
- предварительные задачи следующих релизов;
- общий backlog;
- отдельный механизм для критичных инцидентов.
Тогда команда понимает ближайший план, но сохраняет возможность реагировать на изменения. Регулярные релизы и управляемая очередь нужны не ради процесса как такового. Они позволяют убрать две крайности: вечный аврал и бесконечное ожидание.
Бизнес получает понятный ритм развития системы, а команда — возможность планировать работу, нормально тестировать изменения и не превращать каждую небольшую доработку в отдельный рискованный выпуск.
Похожая задача у вас?
Статья описывает общий случай. Опишите свой — разберём на ваших вводных: что применимо, что нет и с чего дешевле начать.
Ещё по теме
Другие материалы из архива — о разработке, процессах и технологиях.

Работа над сайтом — как ремонт: закончить невозможно, можно только приостановить
Мониторинг веб-системы: что нужно контролировать

Вся правда о технической поддержке сайта

SLA или блок часов: какая модель поддержки нужна проекту