Права доступа и источники корпоративной базы знаний с ИИ
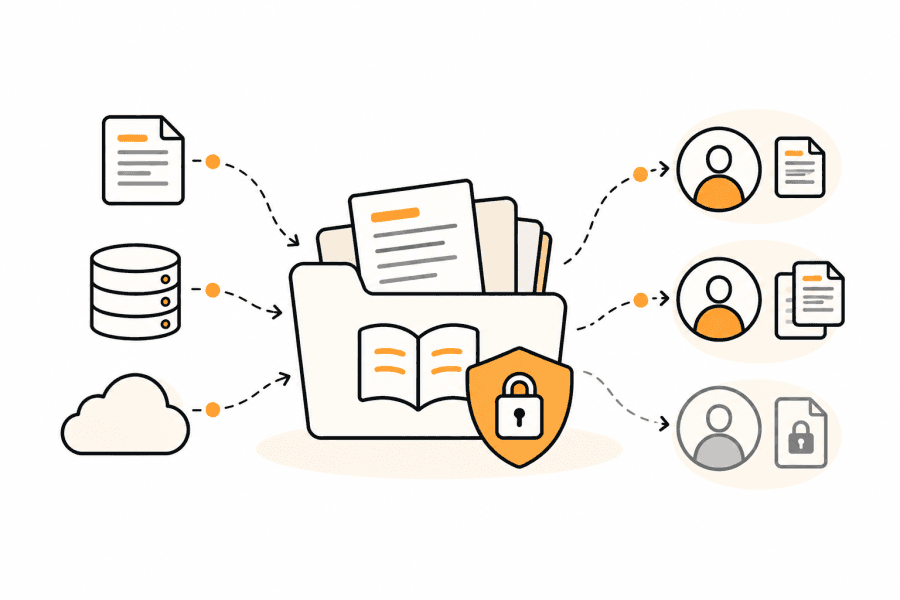
Корпоративная база знаний с ИИ выглядит просто со стороны пользователя: сотрудник задаёт вопрос и получает ответ по внутренним документам компании. Не нужно вспоминать, в какой папке лежит инструкция, искать нужный пункт регламента или открывать несколько систем.
Но как только такой поиск выходит за рамки пилота на десятке специально отобранных документов, появляются два связанных вопроса: откуда система должна брать информацию и какую часть этой информации имеет право видеть конкретный пользователь.
Если загрузить в одну базу все корпоративные документы без учёта доступа, ИИ может превратить разрозненные папки в удобную точку утечки данных. Если, наоборот, слишком сильно ограничить источники, сотрудники продолжат искать информацию вручную. Поэтому корпоративная база знаний — это не просто набор документов для RAG. Её нужно проектировать как систему, в которой для каждого источника понятны владелец, актуальность, правила доступа и место в общей информационной архитектуре компании.
Сначала нужно определить, что считать базой знаний
База знаний компании редко существует в одном месте. Часть информации хранится в корпоративном портале, часть — на сетевом диске или в облачном хранилище. Регламенты могут находиться в системе документооборота, инструкции — в wiki, данные о клиентах — в CRM, техническая документация — в Git, а отдельные рабочие материалы — в общих папках подразделений.
Поэтому первый этап — не загрузка файлов в векторную базу, а инвентаризация источников.
Нужно понять:
- где находится полезная информация;
- какие типы данных там хранятся;
- кто отвечает за источник;
- насколько информация актуальна;
- кто имеет к ней доступ сейчас;
- как часто она меняется;
- можно ли подключаться к источнику автоматически.
Уже на этом этапе может выясниться, что задача значительно шире первоначальной идеи «подключить ИИ к корпоративным документам».
Не каждый источник нужно подключать
Техническая возможность получить данные ещё не означает, что их стоит включать в базу знаний. Например, в общей папке могут годами храниться черновики, старые версии инструкций и документы без понятного владельца. Если проиндексировать всё содержимое, ИИ начнёт использовать его наравне с актуальными материалами. Поэтому для каждого источника полезно определить его роль.
Есть официальные регламенты, которым можно доверять. Есть рабочие документы, которые полезны как дополнительный контекст. Есть архив, который нужен только в отдельных случаях. А часть информации вообще не должна участвовать в поиске.
Таким образом, задача состоит не в том, чтобы собрать максимум данных, а в том, чтобы подключить достаточный набор управляемых источников.
У каждого источника должен быть владелец
Если система нашла два документа с разными правилами, кто должен определить правильный?
Это не вопрос для языковой модели.
У корпоративной информации должны быть владельцы — подразделения или конкретные роли, отвечающие за её содержание. Например, кадровые регламенты находятся в зоне ответственности HR, финансовые инструкции — финансового подразделения, техническая документация — соответствующей команды.
Владелец определяет, какой документ актуален, когда его нужно обновить и можно ли использовать его в корпоративном поиске. Без этого база знаний постепенно превращается в ещё одно хранилище, где информации много, но степень доверия к ней непонятна.
Актуальность важнее объёма
Представим, что в базе лежат две инструкции по одному процессу. Первая опубликована три года назад, вторая — месяц назад. Для человека разница может быть очевидна по дате или расположению файла. Для поисковой системы оба документа могут оказаться релевантными запросу.
Если старый документ не был удалён или помечен как архивный, он способен попасть в контекст модели и повлиять на ответ.
Поэтому при подключении источников нужно определить жизненный цикл информации: появление → использование → обновление → архивирование или удаление.
Желательно, чтобы статус документа можно было учитывать автоматически. Тогда архивный регламент не будет конкурировать с действующим только потому, что в нём встречаются те же ключевые слова.
Источник истины должен быть определён заранее
Одни и те же сведения могут существовать сразу в нескольких системах. Например, структура подразделений есть в корпоративном портале, таблице HR и внутреннем справочнике. Информация о продукте — в PIM, интернет-магазине и презентации отдела продаж.
Если данные расходятся, ИИ не должен самостоятельно решать, какой вариант правильный.
Для значимых типов информации полезно определить источник истины — систему или набор документов, которым отдается приоритет. Это особенно важно, если корпоративная база знаний объединяет структурированные данные и документы. Например, актуальный статус заказа лучше получать из ERP или CRM, а правила его обработки — из регламента. Оба источника нужны для ответа, но выполняют разные функции.
Корпоративный поиск не должен расширять права пользователя
Это один из основных принципов проектирования. Если сотрудник не имеет доступа к документу напрямую, появление ИИ-интерфейса не должно неожиданно дать ему возможность узнать его содержание.На первый взгляд кажется достаточным просто не показывать закрытый документ в результатах поиска. Но для RAG-системы этого мало. Если запрещённый фрагмент уже попал в контекст языковой модели, информация может оказаться в сформированном ответе, даже если ссылка на исходный документ скрыта. Поэтому права нужно учитывать до передачи найденных данных модели, а не только при отображении результата пользователю.
Доступ нужно проверять на этапе поиска
Упрощённо RAG работает так: вопрос → поиск релевантных фрагментов → формирование контекста → LLM → ответ.
В корпоративной системе между поиском и формированием контекста появляется дополнительное условие: может ли этот пользователь видеть каждый найденный фрагмент?
Только разрешённые данные должны попасть в контекст. Например, на вопрос о бонусах сотрудников поисковая система нашла общий регламент и документ с индивидуальными условиями руководителей. Обычному сотруднику доступен только первый источник. Значит, второй документ должен быть исключён ещё до генерации ответа.
Это позволяет сохранить существующую модель доступа и при этом использовать единый поисковый интерфейс.
Права могут наследоваться из исходной системы
Если компания уже управляет доступом к документам в SharePoint, корпоративном портале, файловом хранилище или другой системе, создавать параллельную модель прав специально для ИИ не всегда разумно.
При индексации можно сохранять информацию о том, кому доступен исходный объект:
- конкретным пользователям;
- группам;
- подразделениям;
- ролям;
- проектным командам.
Во время поиска система определяет пользователя и фильтрует результаты с учётом этих данных. Так изменение прав в исходной системе может распространяться и на корпоративный поиск. Но для этого нужно заранее понять, как синхронизируются пользователи, группы и разрешения. Простого копирования текста документа недостаточно.
Права бывают сложнее схемы «можно / нельзя»
В реальных корпоративных системах доступ часто зависит от нескольких условий. Например, руководитель видит документы своего подразделения, но не соседнего. Менеджер работает только с клиентами своего региона. Участник проекта имеет доступ к материалам до окончания проекта. Финансовый директор видит все отчёты, а руководитель отдела — только относящиеся к его центру ответственности.
Поэтому у документа могут быть не только общие категории вроде «для HR» или «для руководителей».
Доступ может зависеть от:
- подразделения;
- должности;
- проекта;
- региона;
- юридического лица;
- уровня конфиденциальности;
- конкретного пользователя;
- срока действия разрешения.
Чем сложнее исходная модель, тем важнее не упрощать её при подключении ИИ.
Разные части одного документа могут иметь разные ограничения
Иногда ограничивать доступ нужно не на уровне файла целиком. Представим большой документ, где первая часть содержит общие правила работы, а приложение — финансовые условия, доступные только руководителям.
Если индексировать документ как единый объект с одним набором прав, придётся либо закрыть полезную общую информацию, либо открыть лишнюю. В таких случаях при разбиении документа на фрагменты нужно сохранять не только текст, но и метаданные: источник, раздел, версию, дату, уровень доступа и другие признаки.
Тогда поиск работает уже не с обезличенными кусками текста, а с фрагментами, для которых понятен контекст использования.
Права нужно обновлять вместе с содержимым
Допустим, сотрудник переведён в другое подразделение и больше не должен видеть документы предыдущей команды. Если корпоративная база знаний обновляет права раз в неделю, ещё несколько дней он сможет получать информацию через ИИ. Такая же проблема возникает при изменении доступа к самому документу.
Поэтому для каждого источника нужно определить допустимую задержку синхронизации. Для открытой базы инструкций обновление раз в несколько часов может быть вполне достаточным. Для чувствительных данных требования могут быть значительно строже.
Важно учитывать не только частоту обновления текста, но и частоту обновления разрешений.
Удаление документа тоже должно распространяться на индекс
Одна из неочевидных проблем появляется при удалении информации. Файл удалили из исходной системы, но его фрагменты остались в поисковом индексе или векторной базе. Пользователь больше не видит оригинал, однако ИИ продолжает использовать старое содержание.
Поэтому синхронизация должна поддерживать полный жизненный цикл: создание → изменение → изменение прав → архивирование → удаление.
Если источник больше не существует или перестал быть доступен, соответствующие данные должны перестать участвовать в поиске. Это особенно важно для документов с ограниченным сроком действия.
Не все данные обязательно копировать в отдельное хранилище
Корпоративный поиск можно строить разными способами.
В одном случае документы заранее индексируются и их фрагменты сохраняются в поисковой инфраструктуре. В другом часть информации запрашивается из исходной системы непосредственно в момент обращения. Возможны и гибридные схемы. Выбор зависит от объёма данных, требований к скорости, возможностей API и требований безопасности.
Если компания не допускает копирования определённой категории документов во внешнее хранилище, это архитектурное ограничение нужно учитывать с самого начала. Возможно, для таких данных потребуется локальная инфраструктура, отдельный индекс или вообще другой механизм получения информации.
Нужно учитывать, куда передаются данные после поиска
Проверить доступ пользователя недостаточно. Следующий вопрос — куда отправляется разрешённый фрагмент документа для формирования ответа.
Если используется внешняя LLM через API, корпоративные данные покидают внутренний контур и обрабатываются внешним сервисом. Допустимость такого сценария зависит от типа информации, условий провайдера и требований компании.
Для части проектов это приемлемо. Для других потребуется локальная модель, изолированный контур или разделение данных по категориям. Поэтому ещё на этапе проектирования полезно классифицировать источники не только по доступу сотрудников, но и по тому, где разрешено обрабатывать содержащуюся в них информацию.
Авторизация пользователя должна быть частью архитектуры
Чтобы фильтровать документы по правам, система должна надёжно понимать, кто именно задаёт вопрос. Для внутреннего корпоративного сервиса это может быть существующая система единого входа. Пользователь авторизуется через корпоративную учётную запись, а поиск получает его идентификатор, группы и необходимые атрибуты.
Если ИИ-интерфейс существует отдельно от корпоративной системы авторизации, возникает дополнительная задача синхронизации идентичностей. Нельзя полагаться на данные, которые пользователь вводит сам: например, попросить его выбрать подразделение и на основании этого открыть документы.
Права должны определяться системой, а не заявлением самого пользователя.
В ответе полезно показывать источники
Для корпоративной базы знаний важно не только получить ответ, но и понимать, откуда он взялся. Ссылки на использованные документы позволяют сотруднику:- проверить контекст;
- открыть полный документ;
- убедиться в актуальности;
- увидеть дополнительные детали;
- сообщить об ошибке владельцу информации.
Это особенно полезно для регламентов, юридических документов, инструкций и других областей, где ответ ИИ не должен становиться новым самостоятельным источником истины. При этом ссылка, как и сам ответ, должна учитывать права пользователя. Нельзя показать название или путь к документу, существование которого само по себе является закрытой информацией.
Ответ должен опираться на доступные источники, а не «знания модели»
Если корпоративный ассистент отвечает на вопрос о внутреннем регламенте, пользователю важно понимать, что ответ действительно основан на документах компании. Когда релевантного источника нет, безопаснее сообщить об этом, чем позволить модели достроить правдоподобный ответ из общих знаний.
Например, на вопрос «Сколько дней у нас согласовывается закупка свыше миллиона рублей?» модель может знать типичные корпоративные процессы, но это ничего не говорит о правилах конкретной компании. Поэтому для внутренних фактических вопросов полезно ограничивать генерацию найденными источниками и предусматривать сценарий «информации недостаточно».
Это одновременно повышает качество и упрощает контроль системы.
Противоречия между источниками нужно обнаруживать
Корпоративная база знаний может неожиданно стать инструментом аудита самой информации. Если поиск регулярно находит несколько документов с разными ответами на один вопрос, проблема находится не только в RAG.
Например, в одном регламенте срок согласования составляет три дня, а в другом — пять. Или два подразделения используют разные инструкции, хотя формально должны работать одинаково. Система может фиксировать такие случаи и отправлять их владельцам контента на разбор.
Не стоит поручать модели самостоятельно выбирать «более логичный» вариант. Правильнее определить приоритет источников либо признать наличие противоречия.
Источники полезно разделять по степени доверия
Для ответа на один вопрос могут находиться официальный регламент, презентация двухлетней давности и сообщение из внутренней wiki. По текстовой релевантности последнее может оказаться даже ближе к запросу. Но это не означает, что ему нужно отдавать тот же вес.
При проектировании поиска можно учитывать метаданные:
- тип источника;
- статус документа;
- дату;
- владельца;
- версию;
- уровень доверия.
Например, действующий утверждённый регламент имеет приоритет перед рабочей заметкой. Так база знаний учитывает не только семантическую близость текста, но и корпоративный статус информации.
Источники нужно мониторить
После запуска набор данных продолжает меняться. Может перестать работать коннектор. Источник перестанет обновляться. Часть документов не попадёт в индекс. Права перестанут синхронизироваться после изменения API. Пользователь при этом не обязательно увидит техническую ошибку. Система просто начнёт отвечать по старым или неполным данным.
Поэтому стоит контролировать:
- время последней успешной синхронизации;
- количество обработанных документов;
- ошибки загрузки;
- удалённые и изменённые объекты;
- обновление прав;
- состояние индекса.
Для критичных источников полезны уведомления о сбоях. Корпоративная база знаний — такой же эксплуатируемый сервис, как другие внутренние системы.
Качество поиска нужно проверять с учётом ролей
Обычный тест RAG может состоять из набора вопросов и ожидаемых ответов. Для корпоративной системы этого недостаточно. Один и тот же вопрос полезно проверять от имени пользователей с разными правами.
Например, на запрос о финансовых показателях руководитель получает ответ из закрытого отчёта, а обычный сотрудник — только доступную ему общую информацию либо сообщение об отсутствии данных.
При тестировании нужно убедиться сразу в двух вещах: система находит всё, что пользователь имеет право видеть, и не использует ничего, что ему видеть нельзя. Вторая часть не менее важна первой.
Изменение прав должно попадать в регрессионные сценарии
Особенно опасны ошибки, которые появляются после обновления системы. Например, изменили механизм индексации, улучшили поиск или подключили новый источник — и фильтрация прав стала работать иначе.
Поэтому набор контрольных тестов должен включать сценарии доступа:
- открытый документ доступен всем нужным сотрудникам;
- закрытый не появляется у пользователей без прав;
- изменение группы пользователя меняет доступ;
- удалённый документ перестаёт использоваться;
- закрытый фрагмент не попадает в ответ;
- ссылки на источники соответствуют тем же ограничениям.
Так безопасность проверяется не только перед первым запуском, но и при развитии системы.
Хорошая база знаний начинается не с LLM
Языковая модель — заметная часть корпоративного ИИ-поиска, но многие наиболее важные решения находятся вокруг неё.
Нужно определить источники, владельцев информации и источники истины. Разобраться с актуальностью и версиями документов. Перенести существующие правила доступа в поисковый слой. Настроить синхронизацию изменений и удалений. Решить, где разрешено хранить и обрабатывать разные категории данных. И только после этого дать модели разрешённый и релевантный контекст.
Если эти задачи решены, ИИ действительно упрощает доступ к корпоративным знаниям: сотруднику не нужно помнить структуру папок и названия систем. Если нет, удобство поиска может лишь сделать существующий информационный хаос быстрее и доступнее.
Поэтому при проектировании корпоративной базы знаний стоит проверять не только, насколько хорошо система отвечает на вопросы. Не менее важны два других критерия: можно ли доверять источникам ответа и имел ли конкретный пользователь право этот ответ получить.
Похожая задача у вас?
Статья описывает общий случай. Опишите свой — разберём на ваших вводных: что применимо, что нет и с чего дешевле начать.
Ещё по теме
Другие материалы из архива — о разработке, процессах и технологиях.

Как понять, в каком процессе ИИ может дать эффект
Как измерять качество ИИ-агента

Как понять, нужен ли вашему бизнесу ИИ или обычная автоматизация
Как создать ИИ-агента: архитектура, данные, инструменты и интеграции
Массовое создание карточек товаров: где генератора недостаточно

ИИ-агент или чат-бот: в чём разница для бизнеса
От пилота к промышленной эксплуатации ИИ
Как проверять качество обработки документов с ИИ
RAG против обычного поиска: когда нужен каждый подход