Как создать ИИ-агента: архитектура, данные, инструменты и интеграции
ИИ-агента легко представить как более самостоятельную версию чат-бота: пользователь ставит задачу, агент понимает запрос, обращается к нужным данным и выполняет действие. Например, проверяет заказ, находит информацию в базе знаний, создаёт заявку или готовит документ.
Но между «модель умеет рассуждать» и работающим ИИ-агентом находится довольно большая система. Самой языковой модели недостаточно: ей нужны данные, инструменты для выполнения действий, правила доступа, интеграции с корпоративными системами, контроль ошибок и механизм передачи задачи человеку. Поэтому разработка агента начинается не с выбора LLM и даже не с промпта. Сначала нужно определить, какую задачу агент должен выполнять, какие данные ему для этого нужны и какие действия бизнес готов ему доверить.
Начать со сценария, а не с идеи «нам нужен агент»
ИИ-агент имеет смысл там, где недостаточно просто сгенерировать ответ.
Представим службу поддержки интернет-магазина. Клиент спрашивает: «Где мой заказ?» Обычный ИИ-консультант может найти инструкцию о сроках доставки и сформировать общий ответ. Агент способен пройти дальше: определить пользователя, найти его заказ, запросить актуальный статус в учётной системе, проверить информацию службы доставки и сообщить результат.
Более сложный сценарий может выглядеть так: получить обращение → определить проблему → найти заказ → проверить статус → запросить данные службы доставки → при необходимости создать заявку → сообщить клиенту результат.
Здесь ИИ уже не только работает с текстом, а управляет последовательностью действий. Поэтому до разработки полезно описать несколько конкретных сценариев: что является входом, какой результат нужен и какие шаги сейчас выполняет человек.
Если такого процесса описать не получается, возможно, компании пока нужен не агент, а чат-бот, RAG-поиск или обычная автоматизация.
Не каждую последовательность действий нужно отдавать ИИ
Если процесс всегда состоит из пяти фиксированных шагов и не требует выбора, агент может оказаться лишним.
Например: получили форму → создали запись в CRM → отправили письмо → поставили задачу менеджеру.
Такой процесс проще и надёжнее реализовать обычной автоматизацией.
Агент становится полезен, когда на пути появляются развилки. Нужно понять содержание запроса, выбрать подходящий источник, определить следующее действие, обработать нестандартную ситуацию или решить, достаточно ли полученных данных.
При этом не обязательно отдавать модели весь процесс. Часто лучше сочетать обычную программную логику с ИИ: предсказуемые шаги выполняет код, а модель подключается там, где действительно требуется работа с неструктурированной информацией или выбором.
У агента обычно несколько слоёв
На упрощённой демонстрации архитектура может выглядеть как «пользователь → LLM → ответ». В промышленной системе между этими точками появляется гораздо больше компонентов.
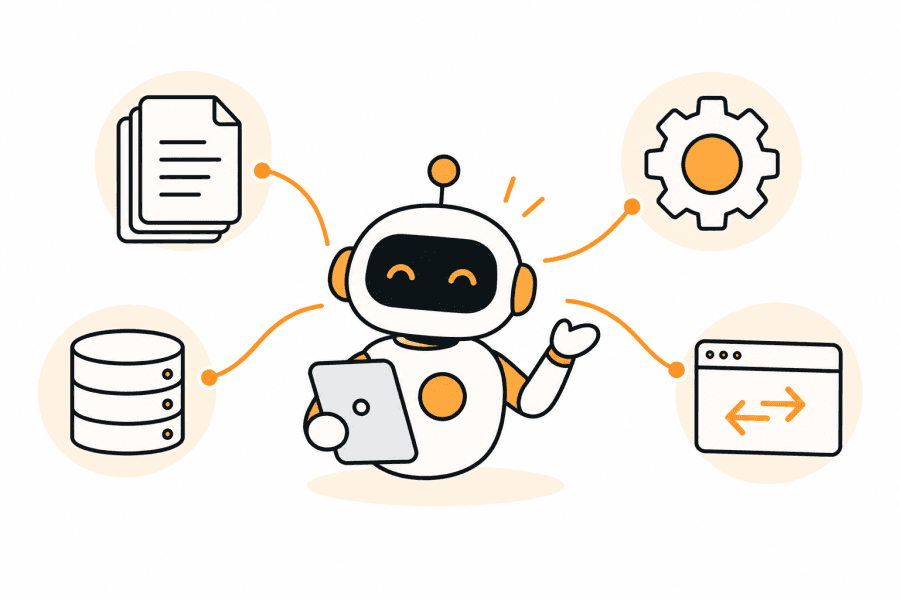
Условно можно выделить несколько слоёв:
- Интерфейс. Место, откуда приходит задача: чат на сайте, корпоративный портал, CRM, мессенджер или внутреннее приложение.
- Логика агента. Компонент, который управляет выполнением задачи: формирует контекст, определяет доступные инструменты, вызывает модель и контролирует последовательность действий.
- Модель. LLM анализирует запрос, работает с контекстом и помогает выбрать следующий шаг.
- Данные. База знаний, документы, карточки клиентов, заказы, справочники и другая информация, необходимая для выполнения задачи.
- Инструменты. Функции, которыми агент может пользоваться: найти заказ, получить остаток, создать обращение, сформировать документ, отправить сообщение.
- Корпоративные системы. ERP, CRM, 1С, Service Desk, интернет-магазин и другие системы, где находятся данные и выполняются реальные операции.
Отдельно вокруг этой схемы появляются безопасность, журналирование, мониторинг и контроль качества.
Архитектура конкретного агента может быть значительно проще или сложнее, но полезно сразу воспринимать его как часть информационной системы, а не как отдельную модель.
Модель не должна напрямую работать со всем подряд
Допустим, агенту нужно узнать статус заказа в ERP. Можно теоретически дать модели доступ к большому API и предложить самостоятельно решить, какой метод вызвать и какие параметры передать. Но чем шире полномочия, тем сложнее контролировать поведение.
Безопаснее предоставить агенту конкретный инструмент: get_order_status(order_id)
Внутри него обычный программный код проверяет параметры, обращается к ERP, обрабатывает ошибки и возвращает результат в понятном формате. Модель решает, когда нужен этот инструмент, но техническая реализация операции остаётся детерминированной.
По такому же принципу можно создать инструменты: find_customer, get_stock, create_ticket, get_invoice, send_for_approval.
Это создаёт понятную границу между вероятностным поведением модели и обычным программным кодом.
Инструмент должен соответствовать бизнес-действию
При проектировании tools легко повторить структуру API существующей системы. Но внутренний API не обязательно удобен для агента.
Например, чтобы узнать доступность товара, разработчику приходится сделать четыре запроса: получить карточку, найти идентификаторы складов, запросить остатки и применить правила резервирования.
Необязательно заставлять агента самостоятельно строить эту цепочку каждый раз. Для него можно предоставить один бизнес-инструмент: check_product_availability(product, region).
Внутри уже будет обычная логика работы с несколькими сервисами. Чем понятнее семантика инструмента, тем меньше свободы приходится отдавать модели и тем проще тестировать результат.
Данные для агента бывают разными
Часть информации удобно получать через инструменты. Например, текущий статус заказа или остаток товара. Другая часть находится в неструктурированных источниках: инструкциях, регламентах, договорах, базе знаний. Здесь может использоваться RAG: агент находит релевантные фрагменты документов и передаёт их модели вместе с запросом.
Эти два типа данных важно не смешивать.
Если клиент спрашивает о правилах возврата, ответ можно найти в актуальном регламенте. Если он спрашивает, вернули ли деньги именно по его заказу, требуется запрос в транзакционную систему.
То есть корпоративная база знаний и оперативные бизнес-данные решают разные задачи и могут подключаться к одному агенту разными способами.
Качество исходных данных становится частью качества агента
Агент не исправляет автоматически проблемы корпоративных данных. Если в CRM один клиент заведён трижды, в базе знаний лежат две противоречащие инструкции, а статусы заказов обновляются с шестичасовой задержкой, модель будет работать с этой реальностью.
Поэтому до разработки стоит определить:
- какие данные нужны для каждого сценария;
- где они находятся;
- насколько они актуальны;
- кто является источником истины;
- существуют ли дубли и противоречия;
- какие данные можно передавать модели.
Иногда пилот ИИ-агента довольно быстро показывает, что первый этап проекта должен состоять не в улучшении промпта, а в приведении в порядок источников.
Контекст нельзя увеличивать бесконечно
Кажется логичным передать модели как можно больше информации: всю историю клиента, десятки документов, описание всех инструментов и длинную переписку. Но лишний контекст тоже может ухудшать работу системы, увеличивать время ответа и стоимость. Поэтому агенту лучше давать информацию, которая действительно нужна для текущей задачи.
Например, сначала определить намерение пользователя, затем найти конкретный заказ и только после этого получать необходимые сведения о нём. Документы из базы знаний тоже стоит искать по запросу, а не загружать целиком в каждый диалог.
Архитектура должна управлять контекстом, а не просто накапливать его.
Память агента тоже нужно проектировать
У агента может быть несколько видов памяти.
В рамках одного диалога нужно помнить предыдущие сообщения. Иногда полезно сохранять информацию между обращениями: например, предпочтительный способ доставки или контекст незавершённой задачи. Но сохранять всю переписку навсегда «на всякий случай» не обязательно и не всегда допустимо.
Нужно определить, какие данные действительно имеют долгосрочную ценность, где они хранятся, как обновляются и кто имеет к ним доступ. Особенно важно отличать память агента от корпоративной системы учёта. Если клиент изменил телефон, надёжнее записать новое значение в CRM по предусмотренному процессу, чем надеяться, что агент просто «запомнит» его из разговора.
Агенту не нужно давать максимальные права
Если сотрудник службы поддержки может только просматривать заказ, ИИ-агенту, работающему в том же процессе, вряд ли требуется возможность удалять его. Принцип минимально необходимых прав особенно важен для агентов, потому что они способны самостоятельно выбирать и вызывать инструменты.
Для каждого сценария стоит определить:
- какие данные агент может читать;
- какие действия выполнять;
- какие параметры изменять;
- какие операции запрещены;
- что требует подтверждения человека.
Чем выше цена ошибки, тем меньше автономности имеет смысл предоставлять.
Чтение и изменение данных — разные уровни риска
Первую версию агента часто разумно ограничить чтением. Он может искать информацию, собирать данные из нескольких систем, готовить ответ или предлагать следующее действие. Пользователь или сотрудник принимает решение самостоятельно.
Следующий уровень — агент готовит операцию, но перед выполнением просит подтверждение: Найден заказ №123. Перенести доставку на 25 сентября? Только после подтверждения вызывается соответствующий инструмент.
Автоматическое выполнение без участия человека имеет смысл оставлять для достаточно безопасных и хорошо протестированных сценариев. Таким образом автономность можно увеличивать постепенно вместе с накоплением данных о качестве работы.
Интеграции должны учитывать сбои
Агент работает не в идеальной среде. ERP может не ответить. CRM вернёт ошибку. Поисковый сервис окажется временно недоступен. Один из API ответит слишком долго. Модель не должна в такой ситуации додумывать результат.
Если получить статус заказа не удалось, агент должен понимать, что операция не завершена: повторить запрос по установленным правилам, предложить попробовать позже или передать задачу человеку.
Особенно внимательно нужно относиться к операциям изменения данных. Представим, что агент отправил команду на создание заявки, но не получил ответ из-за сетевого сбоя. Повторный вызов может создать вторую заявку. Поэтому на уровне интеграции нужны защита от дублей, идентификаторы операций и корректная обработка повторных попыток. Это обычные требования к надёжной интеграции — наличие ИИ их не отменяет.
Агент должен уметь остановиться
Одна из важных характеристик промышленного агента — способность не продолжать действие любой ценой. Если данных недостаточно, пользователь не идентифицирован, инструмент вернул противоречивую информацию или задача находится за пределами полномочий, правильным результатом может быть остановка.
Например:
- не хватает данных → запросить уточнение;
- низкая уверенность → передать специалисту;
- операция рискованная → запросить подтверждение;
- нет необходимых прав → отказать в выполнении;
- система недоступна → зафиксировать проблему и предложить альтернативный сценарий.
Такой маршрут нужно проектировать так же тщательно, как успешное выполнение задачи.
Передача человеку — часть архитектуры, а не аварийный выход
Если агент работает с клиентами или внутренними бизнес-процессами, часть задач неизбежно останется за людьми. Поэтому handoff лучше предусмотреть заранее.
Важно передать сотруднику не только сообщение «агент не справился», но и уже собранный контекст: запрос пользователя, найденные данные, выполненные действия и причину эскалации. Тогда специалист продолжает работу с того места, где остановился агент, а не начинает расследование заново.
Кроме того, такие случаи становятся полезным материалом для развития системы: по ним видно, какие сценарии чаще всего выходят за пределы текущих возможностей.
Не каждый агент должен быть мультиагентной системой
Вокруг ИИ-агентов часто встречается идея разделить работу между несколькими специализированными агентами: один планирует, второй ищет данные, третий проверяет результат. Иногда такая архитектура оправданна. Но количество агентов само по себе не делает систему умнее или надёжнее. Каждый дополнительный участник увеличивает число вызовов модели, стоимость, время выполнения и количество возможных ошибок.
Если задачу способен устойчиво выполнять один агент с несколькими хорошо спроектированными инструментами, усложнять архитектуру необязательно. Мультиагентный подход стоит использовать тогда, когда разделение ответственности действительно решает конкретную проблему, а не потому, что сама схема выглядит технологичнее.
Модель выбирают под задачу, а не наоборот
Самая мощная модель не обязательно должна выполнять каждую операцию.
Для простой классификации обращений может хватить более дешёвой и быстрой модели. Для сложного анализа документа — понадобиться более сильная. Некоторые действия вообще выполняются без LLM. Поэтому в одной системе могут использоваться разные модели или комбинация ИИ и обычных алгоритмов.
При выборе стоит учитывать не только качество ответа, но и:
- скорость;
- стоимость;
- размер контекста;
- работу с нужными языками и форматами;
- поддержку вызова инструментов;
- требования к размещению и данным.
В промышленной системе стоимость одного запроса менее показательна, чем стоимость успешно выполненной бизнес-задачи.
Тестировать нужно сценарии целиком
Проверка «модель правильно ответила на вопрос» для агента недостаточна. Нужно проверить всю цепочку: понял задачу → выбрал правильный инструмент → передал корректные параметры → получил данные → интерпретировал результат → выполнил допустимое действие → корректно сообщил итог.
Отдельно тестируются сложные и негативные сценарии: отсутствующие данные, ошибки интеграции, неоднозначные запросы, попытки выполнить запрещённое действие. Особенно важно выделять критические ошибки. Неловкая формулировка ответа и изменение данных не того клиента не могут иметь одинаковый вес в общей оценке качества.
После запуска качество нужно продолжать измерять
Поведение агента может меняться даже без очевидных изменений в коде. Обновилась модель, появились новые документы, изменилась структура API, пользователи начали задавать другие вопросы — и показатели пилота уже не полностью описывают текущую систему.
Поэтому полезно отслеживать:
- долю успешно выполненных задач;
- количество эскалаций;
- ошибки инструментов;
- критические ошибки;
- время выполнения;
- стоимость операций;
- пользовательскую обратную связь.
Для значимых изменений можно повторно запускать набор контрольных сценариев. Ошибки из реальной эксплуатации постепенно пополняют этот набор. Так тестирование превращается из этапа перед запуском в постоянную часть эксплуатации.
Нужна наблюдаемость действий агента
Если система ошиблась, важно восстановить ход операции. Какой запрос получил агент? Какие данные нашёл? Какие инструменты вызвал? С какими параметрами? Что вернули внешние системы? Какая версия модели и конфигурации использовалась?
Без этой информации разбор ошибки превращается в догадки.
При этом логировать всё подряд тоже опасно: в запросах и результатах могут находиться персональные или коммерчески чувствительные данные. Поэтому наблюдаемость проектируется вместе с политикой хранения и доступа к логам.
Промышленный агент — это обычная система с необычным компонентом
ИИ добавляет вероятностный элемент: нельзя заранее жёстко прописать каждую формулировку и каждый путь рассуждения модели. Но всё вокруг него по-прежнему требует обычной инженерной дисциплины.
Интеграции должны переживать сбои. Права — проверяться. Операции — не дублироваться. Изменения — версионироваться. Ошибки — попадать в мониторинг. Критичные действия — журналироваться. Система — иметь сценарий восстановления.
Поэтому хороший ИИ-агент обычно выглядит менее «магически», чем демонстрационный прототип. Модель получает ограниченный набор данных и инструментов, работает внутри определённых правил и передаёт человеку ситуации, где цена самостоятельного решения слишком высока.
Создание такого агента начинается с бизнес-сценария, затем появляются данные и источники истины, инструменты и права, интеграции и правила обработки ошибок. И только внутри этой архитектуры находится сама LLM. Именно такая последовательность позволяет перейти от красивой демонстрации, где агент «что-то умеет», к системе, которой можно доверить реальную часть бизнес-процесса.
Похожая задача у вас?
Статья описывает общий случай. Опишите свой — разберём на ваших вводных: что применимо, что нет и с чего дешевле начать.
Ещё по теме
Другие материалы из архива — о разработке, процессах и технологиях.
ИИ-агент или чат-бот: в чём разница для бизнеса
Как понять, в каком процессе ИИ может дать эффект
Как выбрать данные и критерии качества для ИИ-пилота

Как понять, нужен ли вашему бизнесу ИИ или обычная автоматизация
RAG против обычного поиска: когда нужен каждый подход
Как измерять качество ИИ-агента
Массовое создание карточек товаров: где генератора недостаточно